
Transformers documentation
FastSpeech2Conformer
Эта модель была опубликована в HF papers 26.10.2020 и добавлена в Hugging Face Transformers 03.01.2024.
FastSpeech2Conformer
Обзор
Модель FastSpeech2Conformer была предложена в статье Recent Developments On Espnet Toolkit Boosted By Conformer авторов Pengcheng Guo, Florian Boyer, Xuankai Chang, Tomoki Hayashi, Yosuke Higuchi, Hirofumi Inaguma, Naoyuki Kamo, Chenda Li, Daniel Garcia-Romero, Jiatong Shi, Jing Shi, Shinji Watanabe, Kun Wei, Wangyou Zhang и Yuekai Zhang.
Аннотация из оригинальной статьи FastSpeech2 гласит следующее:
Неавто регрессионные модели синтеза речи (TTS), такие как FastSpeech (Ren et al., 2019), способны синтезировать речь значительно быстрее предыдущих авто регрессионных моделей при сопоставимом качестве. Обучение модели FastSpeech опирается на авто регрессионную модель-учителя для предсказания длительности (чтобы предоставить больше информации на входе) и дистилляцию знаний (чтобы упростить распределение данных на выходе), что позволяет смягчить проблему отображения «один ко многим» (то есть нескольким вариантам речи соответствует один и тот же текст) в TTS. Однако у FastSpeech есть несколько недостатков: 1) конвейер дистилляции «учитель-ученик» сложен и требует много времени, 2) длительность, извлеченная из модели-учителя, недостаточно точна, а целевые мел-спектрограммы, полученные из модели-учителя путем дистилляции, страдают от потери информации из-за упрощения данных, что ограничивает качество голоса. В данной статье мы предлагаем FastSpeech 2, который решает проблемы FastSpeech и лучше справляется с проблемой отображения «один ко многим» в TTS за счет 1) прямого обучения модели с использованием целевых значений ground-truth вместо упрощенного вывода модели-учителя и 2) введения дополнительной информации о вариациях речи (например, высота тона, энергия и более точная длительность) в качестве условных входных данных. В частности, мы извлекаем длительность, высоту тона и энергию из аудиосигнала и напрямую используем их в качестве условных входных данных при обучении, а при инференсе используем предсказанные значения. Мы также разработали FastSpeech 2s, который является первой попыткой напрямую генерировать аудиосигнал из текста параллельно, что позволяет получить преимущества полностью end-to-end инференса. Экспериментальные результаты показывают, что 1) FastSpeech 2 обеспечивает ускорение обучения в 3 раза по сравнению с FastSpeech, а FastSpeech 2s обладает еще более высокой скоростью инференса; 2) FastSpeech 2 и 2s превосходят FastSpeech по качеству голоса, а FastSpeech 2 может даже превзойти авто регрессионные модели. Аудиопримеры доступны по адресу https://speechresearch.github.io/fastspeech2/.
Эта модель была предоставлена Connor Henderson. Исходный код можно найти здесь.
🤗 Архитектура модели
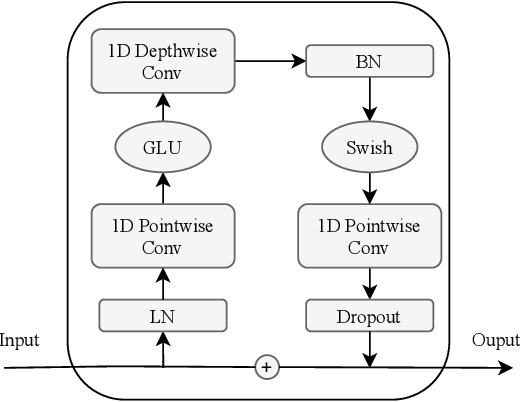
Была реализована общая структура FastSpeech2 с декодером мел-спектрограммы, при этом традиционные блоки трансформера были заменены на блоки конформера, как это сделано в библиотеке ESPnet.
Архитектура модели FastSpeech2

Блоки Conformer

Модуль свёртки
🤗 Использование Transformers
Вы можете запускать FastSpeech2Conformer локально с помощью библиотеки 🤗 Transformers.
- Сначала установите библиотеку 🤗 Transformers и g2p-en:
pip install --upgrade pip
pip install --upgrade transformers g2p-en
- Выполните инференс с помощью кода моделирования Transformers, используя модель и hifigan по отдельности
import soundfile as sf

from transformers import FastSpeech2ConformerHifiGan, FastSpeech2ConformerModel, FastSpeech2ConformerTokenizer


tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
inputs = tokenizer("Hello, my dog is cute.", return_tensors="pt").to(model.device)
input_ids = inputs["input_ids"]

model = FastSpeech2ConformerModel.from_pretrained("espnet/fastspeech2_conformer", device_map="auto")
output_dict = model(input_ids, return_dict=True)
spectrogram = output_dict["spectrogram"]

hifigan = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
waveform = hifigan(spectrogram)

sf.write("speech.wav", waveform.squeeze().detach().numpy(), samplerate=22050)- Выполните инференс с помощью кода моделирования Transformers, объединив модель и hifigan
import soundfile as sf

from transformers import FastSpeech2ConformerTokenizer, FastSpeech2ConformerWithHifiGan


tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
inputs = tokenizer("Hello, my dog is cute.", return_tensors="pt").to(model.device)
input_ids = inputs["input_ids"]

model = FastSpeech2ConformerWithHifiGan.from_pretrained("espnet/fastspeech2_conformer_with_hifigan")
output_dict = model(input_ids, return_dict=True)
waveform = output_dict["waveform"]

sf.write("speech.wav", waveform.squeeze().detach().numpy(), samplerate=22050)- Выполните инференс с помощью pipeline и укажите, какой вокодер использовать
import soundfile as sf

from transformers import FastSpeech2ConformerHifiGan, pipeline


vocoder = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
synthesiser = pipeline(model="espnet/fastspeech2_conformer", vocoder=vocoder)

speech = synthesiser("Hello, my dog is cooler than you!")

sf.write("speech.wav", speech["audio"].squeeze(), samplerate=speech["sampling_rate"])
FastSpeech2ConformerConfig
класс transformers.FastSpeech2ConformerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0id2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneis_encoder_decoder: bool = Truehidden_size: int = 384vocab_size: int = 78num_mel_bins: int = 80encoder_num_attention_heads: int = 2encoder_layers: int = 4encoder_linear_units: int = 1536decoder_layers: int = 4decoder_num_attention_heads: int = 2decoder_linear_units: int = 1536speech_decoder_postnet_layers: int = 5speech_decoder_postnet_units: int = 256speech_decoder_postnet_kernel: int = 5positionwise_conv_kernel_size: int = 3encoder_normalize_before: bool = Falsedecoder_normalize_before: bool = Falseencoder_concat_after: bool = Falsedecoder_concat_after: bool = Falsereduction_factor: int = 1speaking_speed: float = 1.0use_macaron_style_in_conformer: bool = Trueuse_cnn_in_conformer: bool = Trueencoder_kernel_size: int = 7decoder_kernel_size: int = 31duration_predictor_layers: int = 2duration_predictor_channels: int = 256duration_predictor_kernel_size: int = 3energy_predictor_layers: int = 2energy_predictor_channels: int = 256energy_predictor_kernel_size: int = 3energy_predictor_dropout: float | int = 0.5energy_embed_kernel_size: int = 1energy_embed_dropout: float | int = 0.0stop_gradient_from_energy_predictor: bool = Falsepitch_predictor_layers: int = 5pitch_predictor_channels: int = 256pitch_predictor_kernel_size: int = 5pitch_predictor_dropout: float | int = 0.5pitch_embed_kernel_size: int = 1pitch_embed_dropout: float | int = 0.0stop_gradient_from_pitch_predictor: bool = Trueencoder_dropout_rate: float | int = 0.2encoder_positional_dropout_rate: float | int = 0.2encoder_attention_dropout_rate: float | int = 0.2decoder_dropout_rate: float | int = 0.2decoder_positional_dropout_rate: float | int = 0.2decoder_attention_dropout_rate: float | int = 0.2duration_predictor_dropout_rate: float | int = 0.2speech_decoder_postnet_dropout: float | int = 0.5max_source_positions: int = 5000use_masking: bool = Trueuse_weighted_masking: bool = Falsenum_speakers: int | None = Nonenum_languages: int | None = Nonespeaker_embed_dim: int | None = Noneconvolution_bias: bool = True )
Параметры
- is_encoder_decoder (
bool, необязательный, по умолчаниюTrue) — Указывает, используется ли модель в качестве энкодера/декодера. - hidden_size (
int, необязательный, по умолчанию384) — Размерность скрытых представлений. - vocab_size (
int, необязательный, по умолчанию78) — Размер словаря модели. Определяет количество различных токенов, которые могут быть представлены вinput_ids. - num_mel_bins (
int, необязательный, по умолчанию80) — Количество mel-признаков, используемых на входной кадр. Должно соответствовать значению, применяемому в классеAutoFeatureExtractor. - encoder_num_attention_heads (
int, необязательный, по умолчанию 2) — Количество головок внимания в кодере. - encoder_layers (
int, необязательный, по умолчанию4) — Количество скрытых слоев в кодере Transformer. Если не задано, используется то же значение, что и уnum_layers. - encoder_linear_units (
int, необязательный, по умолчанию 1536) — Количество нейронов в линейном слое энкодера. - decoder_layers (
int, необязательный, по умолчанию4) — Количество скрытых слоев в декодере Transformer. Если не задано, используется то же значение, что и уnum_layers. - decoder_num_attention_heads (
int, необязательный, по умолчанию2) — Количество головок внимания в каждом слое внимания декодера Transformer. - decoder_linear_units (
int, необязательный, по умолчанию 1536) — Количество нейронов в линейном слое декодера. - speech_decoder_postnet_layers (
int, необязательный, по умолчанию 5) — Количество слоев в пост-сети речевого декодера. - speech_decoder_postnet_units (
int, необязательный, по умолчанию 256) — Количество единиц в слоях post-net речевого декодера. - speech_decoder_postnet_kernel (
int, необязательный, по умолчанию 5) — Размер ядра в post-net речевого декодера. - positionwise_conv_kernel_size (
int, необязательный, по умолчанию 3) — Размер ядра свёртки, используемого в поэлементном слое. - encoder_normalize_before (
bool, необязательный, по умолчаниюFalse) — Определяет, следует ли нормализовать данные перед слоями энкодера. - decoder_normalize_before (
bool, необязательный, по умолчаниюFalse) — Определяет, следует ли выполнять нормализацию перед слоями декодера. - encoder_concat_after (
bool, необязательный, по умолчаниюFalse) — Определяет, нужно ли выполнять конкатенацию после слоев энкодера. - decoder_concat_after (
bool, необязательный, по умолчаниюFalse) — Определяет, нужно ли выполнять конкатенацию после слоев декодера. - reduction_factor (
int, необязательный, по умолчанию 1) — Коэффициент, на который снижается частота кадров речи. - speaking_speed (
float, необязательный, по умолчанию 1.0) — Скорость произносимой речи. - use_macaron_style_in_conformer (
bool, необязательный, по умолчаниюTrue) — Определяет, следует ли использовать macaron style в conformer. - use_cnn_in_conformer (
bool, необязательный, по умолчаниюTrue) — Определяет, следует ли использовать свёрточные нейронные сети в conformer. - encoder_kernel_size (
int, необязательный, по умолчанию 7) — Размер ядра, используемого в кодере. - decoder_kernel_size (
int, необязательный, по умолчанию 31) — Размер ядра, используемый в декодере. - duration_predictor_layers (
int, необязательный, по умолчанию 2) — Количество слоев в предикторе длительности. - duration_predictor_channels (
int, необязательный, по умолчанию 256) — Количество каналов в предикторе длительности. - duration_predictor_kernel_size (
int, необязательный, по умолчанию 3) — Размер ядра, используемый в предикторе длительности. - energy_predictor_layers (
int, необязательный, по умолчанию 2) — Количество слоев в предикторе энергии. - energy_predictor_channels (
int, необязательный, по умолчанию 256) — Количество каналов в предикторе энергии. - energy_predictor_kernel_size (
int, необязательный, по умолчанию 3) — Размер ядра, используемый в предикторе энергии. - energy_predictor_dropout (
float, необязательный, по умолчанию 0.5) — Коэффициент dropout в предикторе энергии. - energy_embed_kernel_size (
int, необязательный, по умолчанию 1) — Размер ядра, используемый в слое energy embed. - energy_embed_dropout (
float, необязательный, по умолчанию 0.0) — Коэффициент dropout в слое energy embed. - stop_gradient_from_energy_predictor (
bool, необязательный, по умолчаниюFalse) — Определяет, следует ли останавливать распространение градиентов от предиктора энергии. - pitch_predictor_layers (
int, необязательный, по умолчанию 5) — Количество слоёв в предикторе высоты тона. - pitch_predictor_channels (
int, необязательный, по умолчанию 256) — Количество каналов в предикторе питча. - pitch_predictor_kernel_size (
int, необязательный, по умолчанию 5) — Размер ядра, используемый в предсказателе высоты тона. - pitch_predictor_dropout (
float, необязательный, по умолчанию 0.5) — Коэффициент dropout в предсказателе высоты тона. - pitch_embed_kernel_size (
int, необязательный, по умолчанию 1) — Размер ядра, используемый в слое pitch embed. - pitch_embed_dropout (
float, необязательный, по умолчанию 0.0) — Коэффициент dropout в слое pitch embed. - stop_gradient_from_pitch_predictor (
bool, необязательный, по умолчаниюTrue) — Определяет, следует ли останавливать распространение градиентов от предиктора высоты тона. - encoder_dropout_rate (
float, необязательный, по умолчанию 0.2) — Коэффициент dropout в энкодере. - encoder_positional_dropout_rate (
float, необязательный, по умолчанию 0.2) — Коэффициент dropout для позиционных эмбеддингов в энкодере. - encoder_attention_dropout_rate (
float, необязательный, по умолчанию 0.2) — Коэффициент dropout для механизма внимания в энкодере. - decoder_dropout_rate (
float, необязательный, по умолчанию 0.2) — Коэффициент dropout в декодере. - decoder_positional_dropout_rate (
float, необязательный, по умолчанию 0.2) — Коэффициент dropout для позиционных эмбеддингов в декодере. - decoder_attention_dropout_rate (
float, необязательный, по умолчанию 0.2) — Коэффициент dropout для механизма внимания в декодере. - duration_predictor_dropout_rate (
float, необязательный, по умолчанию 0.2) — Коэффициент dropout в предикторе длительности. - speech_decoder_postnet_dropout (
float, необязательный, по умолчанию 0.5) — Коэффициент dropout в постсети декодера речи. - max_source_positions (
int, необязательный, по умолчанию 5000) — если используются позиционные эмбеддинги"relative", определяет максимальные позиции входных данных источника. - use_masking (
bool, необязательный, по умолчаниюTrue) — Определяет, следует ли использовать маскирование в модели. - use_weighted_masking (
bool, необязательный, по умолчаниюFalse) — Определяет, следует ли использовать взвешенное маскирование в модели. - num_speakers (
int, необязательный) — Количество говорящих. Если установлено значение > 1, предполагается, что идентификаторы говорящих будут переданы на вход, и используется слой встраивания идентификаторов говорящих. - num_languages (
int, необязательный) — Количество языков. Если установлено значение > 1, предполагается, что идентификаторы языков будут переданы на вход, и используется слой встраивания идентификаторов языков. - speaker_embed_dim (
int, необязательный) — Размерность спикер-эмбеддинга. Если значение больше 0, предполагается, что speaker_embedding будет передан в качестве входных данных. - convolution_bias (
bool, необязательный, по умолчаниюTrue) — Определяет, следует ли использовать смещение (bias) в свёртках модуля свёртки conformer.
Это класс конфигурации для хранения конфигурации модели FastSpeech2ConformerModel. Он используется для создания модели Fastspeech2 Conformer в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации espnet/fastspeech2_conformer
Объекты конфигурации наследуются от PreTrainedConfig и могут использоваться для управления выводами модели. Подробнее читайте в документации PreTrainedConfig.
Пример:
>>> from transformers import FastSpeech2ConformerModel, FastSpeech2ConformerConfig

>>> # Initializing a FastSpeech2Conformer style configuration
>>> configuration = FastSpeech2ConformerConfig()

>>> # Initializing a model from the FastSpeech2Conformer style configuration
>>> model = FastSpeech2ConformerModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerHifiGanConfig
класс transformers.FastSpeech2ConformerHifiGanConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonemodel_in_dim: int = 80upsample_initial_channel: int = 512upsample_rates: list[int] | tuple[int, ...] = (8, 8, 2, 2)upsample_kernel_sizes: list[int] | tuple[int, ...] = (16, 16, 4, 4)resblock_kernel_sizes: list[int] | tuple[int, ...] = (3, 7, 11)resblock_dilation_sizes: list | tuple | None = Noneinitializer_range: float = 0.01leaky_relu_slope: float = 0.1normalize_before: bool = True )
Параметры
- model_in_dim (
int, необязательный, по умолчанию 80) — Количество частотных бинов во входной лог-мел-спектрограмме. - upsample_initial_channel (
int, необязательный, по умолчанию 512) — Количество входных каналов в сети апсемплинга. - upsample_rates (
tuple[int]илиlist[int], необязательный, по умолчанию[8, 8, 2, 2]) — Кортеж целых чисел, определяющий шаг каждого слоя одномерной свёртки в сети апсемплинга. Длина upsample_rates определяет количество свёрточных слоёв и должна совпадать с длиной upsample_kernel_sizes. - upsample_kernel_sizes (
tuple[int]илиlist[int], необязательный, по умолчанию[16, 16, 4, 4]) — Кортеж целых чисел, определяющий размер ядра каждого одномерного свёрточного слоя в сети апсемплинга. Длина upsample_kernel_sizes определяет количество свёрточных слоёв и должна совпадать с длиной upsample_rates. - resblock_kernel_sizes (
tuple[int]илиlist[int], необязательный, по умолчанию[3, 7, 11]) — Кортеж целых чисел, определяющий размеры ядер одномерных свёрточных слоёв в модуле многомасштабного слияния (MRF). - resblock_dilation_sizes (
tuple[tuple[int]]илиlist[list[int]], необязательный, по умолчанию[[1, 3, 5], [1, 3, 5], [1, 3, 5]]) — Вложенный кортеж целых чисел, определяющий коэффициенты дилатации для дилатационных одномерных свёрточных слоёв в модуле multi-receptive field fusion (MRF). - initializer_range (
float, необязательный, по умолчанию0.01) — Стандартное отклонение truncated_normal_initializer, используемое для инициализации всех матриц весов. - leaky_relu_slope (
float, необязательный, по умолчанию 0.1) — Угол отрицательного наклона, используемого активацией leaky ReLU. - normalize_before (
bool, необязательный, по умолчаниюTrue) — Указывает, следует ли нормализовать спектрограмму перед вокодером, используя усреднённые значения и дисперсию, выученные вокодером.
Это класс конфигурации для хранения конфигурации модели FastSpeech2ConformerModel. Он используется для создания модели Fastspeech2 Conformer в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации espnet/fastspeech2_conformer_with_hifigan
Объекты конфигурации наследуются от PreTrainedConfig и могут использоваться для управления выводами модели. Подробнее читайте в документации PreTrainedConfig.
Пример:
>>> from transformers import FastSpeech2ConformerHifiGan, FastSpeech2ConformerHifiGanConfig

>>> # Initializing a FastSpeech2ConformerHifiGan configuration
>>> configuration = FastSpeech2ConformerHifiGanConfig()

>>> # Initializing a model (with random weights) from the configuration
>>> model = FastSpeech2ConformerHifiGan(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerWithHifiGanConfig
класс transformers.FastSpeech2ConformerWithHifiGanConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonemodel_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonevocoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None )
Это класс конфигурации для хранения конфигурации модели FastSpeech2ConformerModel. Он используется для создания модели Fastspeech2 Conformer в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации espnet/fastspeech2_conformer_with_hifigan
Объекты конфигурации наследуются от PreTrainedConfig и могут использоваться для управления выводами модели. Подробнее читайте в документации PreTrainedConfig.
Пример:
>>> from transformers import (
...     FastSpeech2ConformerConfig,
...     FastSpeech2ConformerHifiGanConfig,
...     FastSpeech2ConformerWithHifiGanConfig,
...     FastSpeech2ConformerWithHifiGan,
... )

>>> # Initializing FastSpeech2ConformerWithHifiGan sub-modules configurations.
>>> model_config = FastSpeech2ConformerConfig()
>>> vocoder_config = FastSpeech2ConformerHifiGanConfig()

>>> # Initializing a FastSpeech2ConformerWithHifiGan module style configuration
>>> configuration = FastSpeech2ConformerWithHifiGanConfig(model_config.to_dict(), vocoder_config.to_dict())

>>> # Initializing a model (with random weights)
>>> model = FastSpeech2ConformerWithHifiGan(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerTokenizer
класс transformers.FastSpeech2ConformerTokenizer
< source >( vocab_filebos_token = '<sos/eos>'eos_token = '<sos/eos>'pad_token = '<blank>'unk_token = '<unk>'should_strip_spaces = False**kwargs )
Параметры
- vocab_file (
str) — Путь к файлу словаря. - bos_token (
str, необязательный, по умолчанию"<sos/eos>") — Токен начала последовательности. Обратите внимание, что для FastSpeech2 он совпадает сeos_token. - eos_token (
str, необязательный, по умолчанию"<sos/eos>") — Токен конца последовательности. Обратите внимание, что для FastSpeech2 он совпадает сbos_token. - pad_token (
str, необязательный, по умолчанию"<blank>") — Токен, используемый для выравнивания (padding), например, при пакетной обработке последовательностей разной длины. - unk_token (
str, необязательный, по умолчанию"<unk>") — Токен неизвестного слова. Токен, отсутствующий в словаре, не может быть преобразован в ID, поэтому вместо него используется этот токен. - should_strip_spaces (
bool, необязательный, по умолчаниюFalse) — Удалять ли пробелы из списка токенов.
Создайте токенизатор FastSpeech2Conformer.
__call__
< source >( text: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Noneadd_special_tokens: bool = Truepadding: bool | str | PaddingStrategy = Falsetruncation: bool | str | TruncationStrategy | None = Nonemax_length: int | None = Nonestride: int = 0is_split_into_words: bool = Falsepad_to_multiple_of: int | None = Nonepadding_side: str | None = Nonereturn_tensors: str | TensorType | None = Nonereturn_token_type_ids: bool | None = Nonereturn_attention_mask: bool | None = Nonereturn_overflowing_tokens: bool = Falsereturn_special_tokens_mask: bool = Falsereturn_offsets_mapping: bool = Falsereturn_length: bool = Falseverbose: bool = Truetokenizer_kwargs: dict[str, Any] | None = None**kwargs ) → BatchEncoding
Параметры
- text (
str,list[str],list[list[str]], необязательный) — Последовательность или батч последовательностей для кодирования. Каждая последовательность может быть строкой или списком строк (предварительно токенизированная строка). Если последовательности предоставлены в виде списка строк (предварительно токенизированных), необходимо установитьis_split_into_words=True(чтобы устранить неоднозначность с батчем последовательностей). - text_pair (
str,list[str],list[list[str]], необязательный) — Последовательность или батч последовательностей для кодирования. Каждая последовательность может быть строкой или списком строк (предварительно токенизированная строка). Если последовательности предоставлены в виде списка строк (предварительно токенизированных), необходимо установитьis_split_into_words=True(чтобы устранить неоднозначность с батчем последовательностей). - text_target (
str,list[str],list[list[str]], необязательный) — Последовательность или батч последовательностей, которые будут закодированы как целевые тексты. Каждая последовательность может быть строкой или списком строк (предтокенизированная строка). Если последовательности предоставлены в виде списка строк (предтокенизированных), необходимо установитьis_split_into_words=True(чтобы устранить неоднозначность с батчем последовательностей). - text_pair_target (
str,list[str],list[list[str]], необязательный) — Последовательность или батч последовательностей, которые будут закодированы как целевые тексты. Каждая последовательность может быть строкой или списком строк (предтокенизированная строка). Если последовательности предоставлены в виде списка строк (предтокенизированных), необходимо установитьis_split_into_words=True(чтобы устранить неоднозначность с батчем последовательностей). - tokenizer_kwargs (
dict[str, Any], необязательный) — Дополнительные kwargs для передачи в токенизатор. Они будут объединены с явными параметрами и другими kwargs, при этом явные параметры имеют приоритет. - add_special_tokens (
bool, необязательный, по умолчаниюTrue) — Указывает, следует ли добавлять специальные токены при кодировании последовательностей. Для этого используется базовая функцияPretrainedTokenizerBase.build_inputs_with_special_tokens, которая определяет, какие токены автоматически добавляются к входным идентификаторам. Это полезно, если вы хотите автоматически добавлять токеныbosилиeos. - padding (
bool,strили PaddingStrategy, необязательный, по умолчаниюFalse) — Включает и управляет выравниванием. Принимает следующие значения:Trueили'longest': дополнить до самой длинной последовательности в батче (или не дополнять, если предоставлена только одна последовательность).'max_length': Дополнить до максимальной длины, указанной аргументомmax_length, или до максимально допустимой длины входных данных для модели, если этот аргумент не указан.Falseили'do_not_pad'(по умолчанию): без дополнения нулями (т. е. может выводить батч с последовательностями разной длины).
- truncation (
bool,strили TruncationStrategy, необязательный, по умолчаниюFalse) — Включает и управляет усечением. Принимает следующие значения:Trueили'longest_first': обрезка до максимальной длины, заданной аргументомmax_length, или до максимально допустимой длины входа для модели, если этот аргумент не указан. Обрезка выполняется посимвольно: если предоставлена пара последовательностей (или батч пар), то токен удаляется из самой длинной последовательности в паре.'only_first': Обрезка до максимальной длины, указанной аргументомmax_length, или до максимально допустимой длины входа для модели, если этот аргумент не задан. Если предоставлена пара последовательностей (или батч пар), будет обрезана только первая последовательность пары.'only_second': Обрезка до максимальной длины, указанной аргументомmax_length, или до максимальной допустимой длины входа для модели, если этот аргумент не задан. Это приводит к обрезке только второй последовательности в паре, если предоставлена пара последовательностей (или батч пар).Falseили'do_not_truncate'(по умолчанию): без усечения (т.е. может выдать батч с длиной последовательности, превышающей максимальный допустимый размер входа модели).
- max_length (
int, необязательный) — Управляет максимальной длиной, используемой одним из параметров усечения/дополнения.Если параметр не задан или установлен в
None, будет использована предопределённая максимальная длина модели, если одна из параметров усечения/дополнения требует указания максимальной длины. Если у модели нет конкретной максимальной длины входных данных (как у XLNet), усечение/дополнение до максимальной длины будет отключено. - stride (
int, необязательный, по умолчанию 0) — Если задано число вместе сmax_length, то переполненные токены, возвращаемые приreturn_overflowing_tokens=True, будут содержать некоторые токены из конца усечённой последовательности, чтобы обеспечить перекрытие между усечённой и переполненной последовательностями. Значение этого аргумента определяет количество перекрывающихся токенов. - is_split_into_words (
bool, необязательный, по умолчаниюFalse) — Указывает, является ли вход уже предтокенизированным (например, разбитым на слова). Если установлено вTrue, токенизатор предполагает, что вход уже разбит на слова (например, по пробелам), и токенизирует их. Это полезно для NER или классификации токенов. - pad_to_multiple_of (
int, необязательный) — Если задано, последовательность будет дополнена до кратного указанного значения. Требуется, чтобыpaddingбыл активирован. Это особенно полезно для использования Tensor Cores на оборудовании NVIDIA с вычислительной способностью>= 7.5(Volta). - padding_side (
str, необязательный) — Сторона, на которой модель должна применять отступы. Следует выбрать одно из значений [‘right’, ‘left’]. Значение по умолчанию выбирается из атрибута класса с тем же именем. - return_tensors (
strили TensorType, необязательный) — Если задано, возвращает тензоры вместо списка целых чисел Python. Допустимые значения:'pt': возвращает объектыtorch.TensorPyTorch.'np': возвращает объекты Numpynp.ndarray.
- return_token_type_ids (
bool, необязательный) — Возвращать ли идентификаторы типов токенов. Если значение не указано, идентификаторы типов токенов будут возвращены в соответствии со значением по умолчанию для конкретного токенизатора, заданным атрибутомreturn_outputs. - return_attention_mask (
bool, необязательный) — Возвращать ли маску внимания. Если значение не указано, маска внимания будет возвращена в соответствии со значением по умолчанию для конкретного токенизатора, определяемым атрибутомreturn_outputs. - return_overflowing_tokens (
bool, необязательный, по умолчаниюFalse) — Возвращать ли последовательности токенов, выходящие за пределы длины. Если передается пара последовательностей входных идентификаторов (или батч пар) сtruncation_strategy = longest_firstилиTrue, вместо возврата переполненных токенов будет выброшена ошибка. - return_special_tokens_mask (
bool, необязательный, по умолчаниюFalse) — Возвращать ли информацию о маске специальных токенов. - return_offsets_mapping (
bool, необязательный, по умолчаниюFalse) — Возвращать ли(char_start, char_end)для каждого токена.Это доступно только для быстрых токенизаторов, наследующих от PreTrainedTokenizerFast. Если используется токенизатор на Python, этот метод вызовет
NotImplementedError. - return_length (
bool, необязательный, по умолчаниюFalse) — Возвращать ли длины закодированных входных данных. - verbose (
bool, необязательный, по умолчаниюTrue) — Выводить ли дополнительную информацию и предупреждения. - **kwargs — передаются в метод
self.tokenize()
Возвращает
BatchEncoding со следующими полями:
-
input_ids — список идентификаторов токенов, которые передаются в модель.
-
token_type_ids — список идентификаторов типов токенов, передаваемых в модель (если
return_token_type_ids=Trueили если “token_type_ids” входит вself.model_input_names). -
attention_mask — список индексов, указывающих, на какие токены модель должна обращать внимание (когда
return_attention_mask=Trueили если “attention_mask” входит вself.model_input_names). -
overflowing_tokens — список переполненных последовательностей токенов (если указано
max_lengthиreturn_overflowing_tokens=True). -
num_truncated_tokens — количество отсечённых токенов (если указано
max_lengthиreturn_overflowing_tokens=True). -
special_tokens_mask — список нулей и единиц, где 1 указывает на добавленные специальные токены, а 0 — на обычные токены последовательности (когда
add_special_tokens=Trueиreturn_special_tokens_mask=True). -
length — длина входных данных (когда
return_length=True)
Основной метод для токенизации и подготовки одной или нескольких последовательностей или одной или нескольких пар последовательностей для модели.
save_vocabulary
< source >( save_directory: strfilename_prefix: str | None = None ) → Tuple(str)
Сохраните файл словаря и специальных токенов в каталог.
batch_decode
< source >( sequences: list[int] | list[list[int]] | np.ndarray | torch.Tensorskip_special_tokens: bool = Falseclean_up_tokenization_spaces: bool | None = None**kwargs ) → list[str]
Параметры
- sequences (
Union[list[int], list[list[int]], np.ndarray, torch.Tensor]) — Список токенизированных входных идентификаторов. Может быть получен с помощью метода__call__. - skip_special_tokens (
bool, необязательный, по умолчаниюFalse) — Удалять ли специальные токены при декодировании. - clean_up_tokenization_spaces (
bool, необязательный) — Определяет, следует ли очищать пробелы токенизации. ЕслиNone, по умолчанию используетсяself.clean_up_tokenization_spaces. - kwargs (дополнительные именованные аргументы, необязательный) — Будут переданы в метод декодирования, специфичный для базовой модели.
Возвращает
list[str]
Список декодированных предложений.
Преобразуйте список списков идентификаторов токенов в список строк, вызвав decode.
Этот метод предоставляется для обратной совместимости. Метод decode теперь нативно обрабатывает пакетный ввод,
поэтому вы можете использовать decode напрямую вместо batch_decode.
FastSpeech2ConformerModel
класс transformers.FastSpeech2ConformerModel
< source >( config: FastSpeech2ConformerConfig )
Параметры
- config (FastSpeech2ConformerConfig) — Класс конфигурации модели, содержащий все параметры модели. Инициализация с помощью файла конфигурации не загружает веса, связанные с моделью, а только конфигурацию. Используйте метод from_pretrained() для загрузки весов модели.
Модель FastSpeech2Conformer.
Эта модель наследуется от PreTrainedModel. См. документацию родительского класса для общих методов, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка голов и т. д.)
Эта модель также является подклассом torch.nn.Module в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
forward
< source >( input_ids: LongTensorattention_mask: typing.Optional[torch.LongTensor] = Nonespectrogram_labels: typing.Optional[torch.Tensor] = Noneduration_labels: typing.Optional[torch.LongTensor] = Nonepitch_labels: typing.Optional[torch.Tensor] = Noneenergy_labels: typing.Optional[torch.Tensor] = Nonespeaker_ids: typing.Optional[torch.LongTensor] = Nonelang_ids: typing.Optional[torch.LongTensor] = Nonespeaker_embedding: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = None**kwargs ) → FastSpeech2ConformerModelOutput or tuple(torch.Tensor)
Параметры
- input_ids (
torch.LongTensorформы(batch_size, sequence_length)) — Входная последовательность текстовых векторов. - attention_mask (
torch.LongTensorформы(batch_size, sequence_length), , необязательный) — Маска для исключения токенов-заполнителей из внимания. Значения маски из диапазона[0, 1]:- 1 для токенов, которые не замаскированы,
- 0 для токенов, которые замаскированы.
- spectrogram_labels (
torch.Tensorформы(batch_size, max_spectrogram_length, num_mel_bins), необязательный, по умолчаниюNone) — Партия дополненных целевых признаков. - duration_labels (
torch.LongTensorформы(batch_size, sequence_length + 1), необязательный, по умолчаниюNone) — Партия дополненных длительностей. - pitch_labels (
torch.Tensorформы(batch_size, sequence_length + 1, 1), необязательный, по умолчаниюNone) — Пакет дополненных усреднённых по токенам значений высоты тона. - energy_labels (
torch.Tensorформы(batch_size, sequence_length + 1, 1), необязательный, по умолчаниюNone) — Пакет усреднённых по токенам значений энергии с дополнением. - speaker_ids (
torch.LongTensorформы(batch_size, 1), необязательный, по умолчаниюNone) — Идентификаторы говорящих, используемые для условного формирования признаков речевого вывода модели. - lang_ids (
torch.LongTensorформы(batch_size, 1), необязательный, по умолчаниюNone) — Идентификаторы языка, используемые для условного формирования признаков речевого вывода модели. - speaker_embedding (
torch.Tensorформы(batch_size, embedding_dim), необязательный, по умолчаниюNone) — Векторное представление, содержащее сигналы для условного формирования признаков речи. - return_dict (
bool, необязательный) — Указывает, следует ли возвращать ModelOutput вместо обычного кортежа. - output_attentions (
bool, необязательный) — Указывает, следует ли возвращать тензоры внимания всех слоев внимания. Подробности см. в описанииattentionsв разделе возвращаемых тензоров. - output_hidden_states (
bool, необязательный) — Указывает, следует ли возвращать скрытые состояния всех слоев. Подробности см. в описанииhidden_statesсреди возвращаемых тензоров.
Возвращает
FastSpeech2ConformerModelOutput или tuple(torch.Tensor)
FastSpeech2ConformerModelOutput или кортеж из
torch.Tensor (если передано return_dict=False или если config.return_dict=False), содержащий различные
элементы в зависимости от конфигурации (FastSpeech2ConformerConfig) и входных данных.
Метод forward модели FastSpeech2ConformerModel переопределяет специальный метод __call__.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр
Module, а не эту функцию, поскольку первый вариант обеспечивает выполнение шагов предварительной и последующей обработки, тогда как второй молча их игнорирует.
loss (
torch.Tensorформы(1,), необязательный, возвращается, если заданlabels) — Потеря генерации спектрограммы.спектрограмма (
torch.Tensorформы(batch_size, sequence_length, num_bins), необязательный) — Предсказанная спектрограмма.encoder_last_hidden_state (
torch.Tensorформы(batch_size, sequence_length, hidden_size), необязательный) — Последовательность скрытых состояний на выходе последнего слоя энкодера модели.encoder_hidden_states (
tuple[torch.Tensor], необязательный, возвращается, если переданоoutput_hidden_states=Trueили еслиconfig.output_hidden_states=True) — Кортежtorch.Tensor(один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы(batch_size, sequence_length, hidden_size).Скрытые состояния кодировщика на выходе каждого слоя, а также выходные значения начального слоя встраиваний.
encoder_attentions (
tuple[torch.Tensor], необязательный, возвращается при передачеoutput_attentions=Trueили когдаconfig.output_attentions=True) — Кортежtorch.Tensor(по одному на каждый слой) формы(batch_size, num_heads, sequence_length, sequence_length).Веса внимания энкодера после softmax внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
decoder_hidden_states (
tuple[torch.Tensor], необязательный, возвращается при передачеoutput_hidden_states=Trueили приconfig.output_hidden_states=True) — Кортежtorch.Tensor(один для вывода эмбеддингов, если у модели есть слой эмбеддингов, + один для вывода каждого слоя) формы(batch_size, sequence_length, hidden_size).Скрытые состояния декодера на выходе каждого слоя, а также выходные значения начального слоя встраивания.
decoder_attentions (
tuple[torch.Tensor], необязательный, возвращается при передачеoutput_attentions=Trueили когдаconfig.output_attentions=True) — Кортежtorch.Tensor(по одному на каждый слой) формы(batch_size, num_heads, sequence_length, sequence_length).Веса внимания декодера после softmax внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
duration_outputs (
torch.LongTensorформы(batch_size, max_text_length + 1), необязательный) — Выходы предиктора длительности.pitch_outputs (
torch.Tensorформы(batch_size, max_text_length + 1, 1), необязательный) — Выходы предиктора высоты тона.energy_outputs (
torch.Tensorформы(batch_size, max_text_length + 1, 1), необязательный) — Выходы предиктора энергии.
Пример:
>>> from transformers import (
...     FastSpeech2ConformerTokenizer,
...     FastSpeech2ConformerModel,
...     FastSpeech2ConformerHifiGan,
... )

>>> tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
>>> inputs = tokenizer("some text to convert to speech", return_tensors="pt")
>>> input_ids = inputs["input_ids"]

>>> model = FastSpeech2ConformerModel.from_pretrained("espnet/fastspeech2_conformer")
>>> output_dict = model(input_ids, return_dict=True)
>>> spectrogram = output_dict["spectrogram"]

>>> vocoder = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
>>> waveform = vocoder(spectrogram)
>>> print(waveform.shape)
torch.Size([1, 49664])
FastSpeech2ConformerHifiGan
класс transformers.FastSpeech2ConformerHifiGan
< source >( config: FastSpeech2ConformerHifiGanConfig )
Параметры
- config (FastSpeech2ConformerHifiGanConfig) — Класс конфигурации модели, содержащий все параметры модели. Инициализация с помощью файла конфигурации не загружает веса, связанные с моделью, а только конфигурацию. Используйте метод from_pretrained() для загрузки весов модели.
Вокодер HiFi-GAN.
Эта модель наследуется от PreTrainedModel. См. документацию родительского класса для общих методов, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка голов и т. д.)
Эта модель также является подклассом torch.nn.Module в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
forward
< source >( spectrogram: Tensor**kwargs ) → torch.Tensor
Параметры
- spectrogram (
torch.Tensor) — Тензор, содержащий лог-мел-спектрограммы. Может быть батчевым с формой(batch_size, sequence_length, config.model_in_dim)или небатчевым с формой(sequence_length, config.model_in_dim).
Возвращает
torch.Tensor
Тензор, содержащий звуковую волну. Если входная спектрограмма имеет батч, форма будет (batch_size, num_frames,). Если без батча, форма будет (num_frames,).
Преобразует лог-мел-спектрограмму в речевую волну. Передача батча лог-мел-спектрограмм возвращает батч речевых волн. Передача одной, не сгруппированной в батч лог-мел-спектрограммы возвращает одну, не сгруппированную в батч речевую волну.
FastSpeech2ConformerWithHifiGan
class transformers.FastSpeech2ConformerWithHifiGan
< source >( config: FastSpeech2ConformerWithHifiGanConfig )
Параметры
- config (FastSpeech2ConformerWithHifiGanConfig) — Класс конфигурации модели, содержащий все параметры модели. Инициализация с помощью файла конфигурации не загружает веса, связанные с моделью, а только конфигурацию. Используйте метод from_pretrained() для загрузки весов модели.
Модель FastSpeech2ConformerModel с головой вокодера FastSpeech2ConformerHifiGan, выполняющей синтез речи из текста (генерацию аудиосигнала).
Эта модель наследуется от PreTrainedModel. См. документацию родительского класса для общих методов, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка голов и т. д.)
Эта модель также является подклассом torch.nn.Module в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
forward
< source >( input_ids: LongTensorattention_mask: typing.Optional[torch.LongTensor] = Nonespectrogram_labels: typing.Optional[torch.Tensor] = Noneduration_labels: typing.Optional[torch.LongTensor] = Nonepitch_labels: typing.Optional[torch.Tensor] = Noneenergy_labels: typing.Optional[torch.Tensor] = Nonespeaker_ids: typing.Optional[torch.LongTensor] = Nonelang_ids: typing.Optional[torch.LongTensor] = Nonespeaker_embedding: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = None**kwargs ) → FastSpeech2ConformerModelOutput or tuple(torch.Tensor)
Параметры
- input_ids (
torch.LongTensorформы(batch_size, sequence_length)) — Входная последовательность текстовых векторов. - attention_mask (
torch.LongTensorформы(batch_size, sequence_length), , необязательный) — Маска для исключения токенов-заполнителей из внимания. Значения маски из диапазона[0, 1]:- 1 для токенов, которые не замаскированы,
- 0 для токенов, которые замаскированы.
- spectrogram_labels (
torch.Tensorформы(batch_size, max_spectrogram_length, num_mel_bins), необязательный, по умолчаниюNone) — Партия дополненных целевых признаков. - duration_labels (
torch.LongTensorформы(batch_size, sequence_length + 1), необязательный, по умолчаниюNone) — Партия дополненных длительностей. - pitch_labels (
torch.Tensorформы(batch_size, sequence_length + 1, 1), необязательный, по умолчаниюNone) — Пакет дополненных усреднённых по токенам значений высоты тона. - energy_labels (
torch.Tensorформы(batch_size, sequence_length + 1, 1), необязательный, по умолчаниюNone) — Пакет усреднённых по токенам значений энергии с дополнением. - speaker_ids (
torch.LongTensorформы(batch_size, 1), необязательный, по умолчаниюNone) — Идентификаторы говорящих, используемые для условного формирования признаков речевого вывода модели. - lang_ids (
torch.LongTensorформы(batch_size, 1), необязательный, по умолчаниюNone) — Идентификаторы языка, используемые для условного формирования признаков речевого вывода модели. - speaker_embedding (
torch.Tensorформы(batch_size, embedding_dim), необязательный, по умолчаниюNone) — Векторное представление, содержащее сигналы для условного формирования признаков речи. - return_dict (
bool, необязательный) — Указывает, следует ли возвращать ModelOutput вместо обычного кортежа. - output_attentions (
bool, необязательный) — Указывает, следует ли возвращать тензоры внимания всех слоев внимания. Подробности см. в описанииattentionsв разделе возвращаемых тензоров. - output_hidden_states (
bool, необязательный) — Указывает, следует ли возвращать скрытые состояния всех слоев. Подробности см. в описанииhidden_statesсреди возвращаемых тензоров.
Возвращает
FastSpeech2ConformerModelOutput или tuple(torch.Tensor)
FastSpeech2ConformerModelOutput или кортеж из
torch.Tensor (если передано return_dict=False или если config.return_dict=False), содержащий различные
элементы в зависимости от конфигурации (FastSpeech2ConformerConfig) и входных данных.
Метод forward класса FastSpeech2ConformerWithHifiGan переопределяет специальный метод __call__.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр
Module, а не эту функцию, поскольку первый вариант обеспечивает выполнение шагов предварительной и последующей обработки, тогда как второй молча их игнорирует.
loss (
torch.Tensorформы(1,), необязательный, возвращается, если заданlabels) — Потеря генерации спектрограммы.спектрограмма (
torch.Tensorформы(batch_size, sequence_length, num_bins), необязательный) — Предсказанная спектрограмма.encoder_last_hidden_state (
torch.Tensorформы(batch_size, sequence_length, hidden_size), необязательный) — Последовательность скрытых состояний на выходе последнего слоя энкодера модели.encoder_hidden_states (
tuple[torch.Tensor], необязательный, возвращается, если переданоoutput_hidden_states=Trueили еслиconfig.output_hidden_states=True) — Кортежtorch.Tensor(один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы(batch_size, sequence_length, hidden_size).Скрытые состояния кодировщика на выходе каждого слоя, а также выходные значения начального слоя встраиваний.
encoder_attentions (
tuple[torch.Tensor], необязательный, возвращается при передачеoutput_attentions=Trueили когдаconfig.output_attentions=True) — Кортежtorch.Tensor(по одному на каждый слой) формы(batch_size, num_heads, sequence_length, sequence_length).Веса внимания энкодера после softmax внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
decoder_hidden_states (
tuple[torch.Tensor], необязательный, возвращается при передачеoutput_hidden_states=Trueили приconfig.output_hidden_states=True) — Кортежtorch.Tensor(один для вывода эмбеддингов, если у модели есть слой эмбеддингов, + один для вывода каждого слоя) формы(batch_size, sequence_length, hidden_size).Скрытые состояния декодера на выходе каждого слоя, а также выходные значения начального слоя встраивания.
decoder_attentions (
tuple[torch.Tensor], необязательный, возвращается при передачеoutput_attentions=Trueили когдаconfig.output_attentions=True) — Кортежtorch.Tensor(по одному на каждый слой) формы(batch_size, num_heads, sequence_length, sequence_length).Веса внимания декодера после softmax внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
duration_outputs (
torch.LongTensorформы(batch_size, max_text_length + 1), необязательный) — Выходы предиктора длительности.pitch_outputs (
torch.Tensorформы(batch_size, max_text_length + 1, 1), необязательный) — Выходы предиктора высоты тона.energy_outputs (
torch.Tensorформы(batch_size, max_text_length + 1, 1), необязательный) — Выходы предиктора энергии.
Пример:
>>> from transformers import (
...     FastSpeech2ConformerTokenizer,
...     FastSpeech2ConformerWithHifiGan,
... )

>>> tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
>>> inputs = tokenizer("some text to convert to speech", return_tensors="pt")
>>> input_ids = inputs["input_ids"]

>>> model = FastSpeech2ConformerWithHifiGan.from_pretrained("espnet/fastspeech2_conformer_with_hifigan")
>>> output_dict = model(input_ids, return_dict=True)
>>> waveform = output_dict["waveform"]
>>> print(waveform.shape)
torch.Size([1, 49664])